Неделя показала, как легко спутать успешный вызов с выполненной задачей. Авторы разбирают сверку исхода после таймаута, проверку конечного состояния агента и канареечные тесты для LLM. В прод-кейсах снова всплывают лишние инструменты, слишком большой контекст и тесты, которые повторяют ошибку сгенерированного кода. Эти статьи дают конкретные проверки для собственных систем.
⚡
Главные статьи недели
01
Таймаут агента требует сверки, прежде чем повторить запуск
Ответ исполнителя тестов может потеряться уже после принятия задания. Автор строит шлюз, который записывает намерение до вызова и различает неизвестный исход и настоящую ошибку.
🔑 Главное
Постоянный ключ связывает запрос с review, suite, environment и коммитами приложения и тестов.
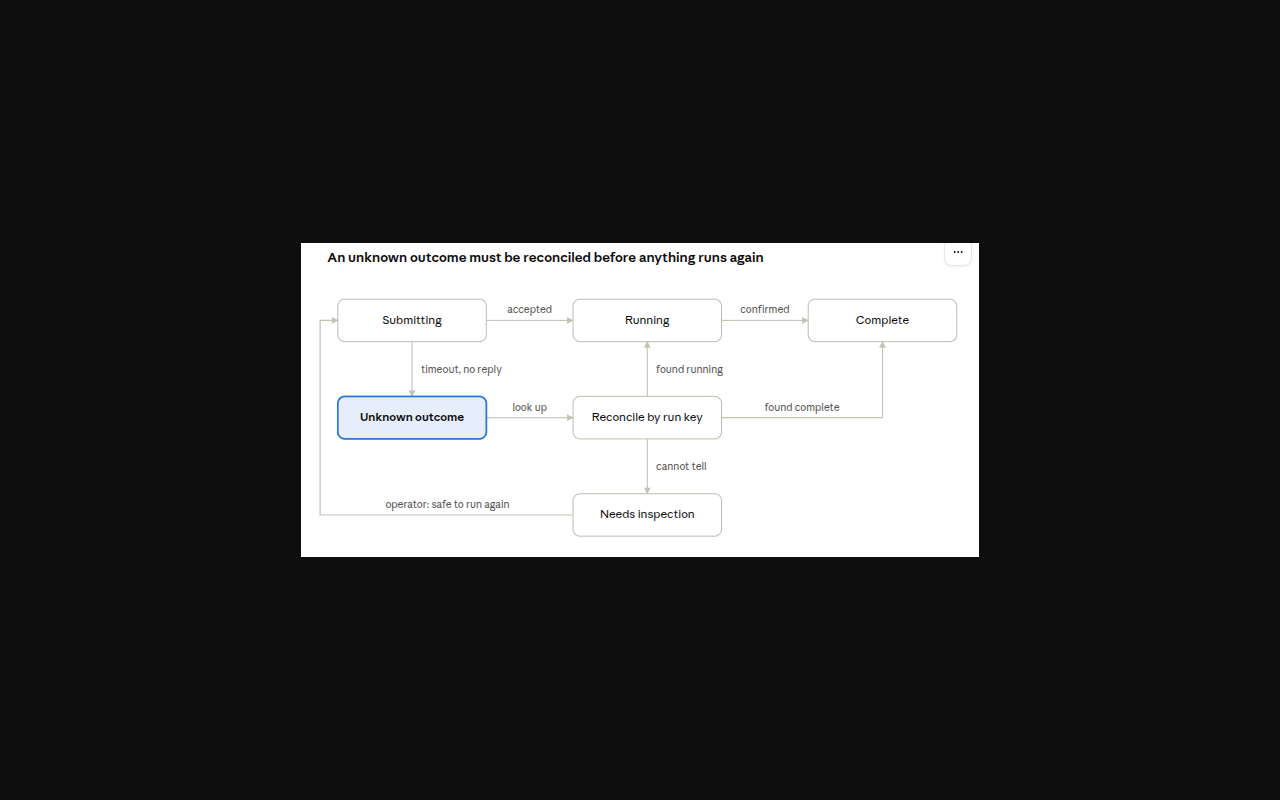
После таймаута запись получает статус unknown. Новый запуск ждёт поиска исходного задания по ключу; неясный результат уходит человеку.
В авторской скриптовой симуляции шлюз убрал дублирующие старты. Поведение живой модели и продакшена не проверено.
⚡ Попробовать за вечер
Возьмите один вызов внешнего runner и сохраняйте intent с постоянным ключом до отправки.
На таймауте запретите повторную отправку, добавьте read-only lookup по исходному ключу и ветку ручной проверки.
Метрика: число дублей runner на серии искусственно оборванных ответов.
из статьи
На картинке: Схема автора: после таймаута попытка переходит в unknown, затем в сверку по run key или к оператору.
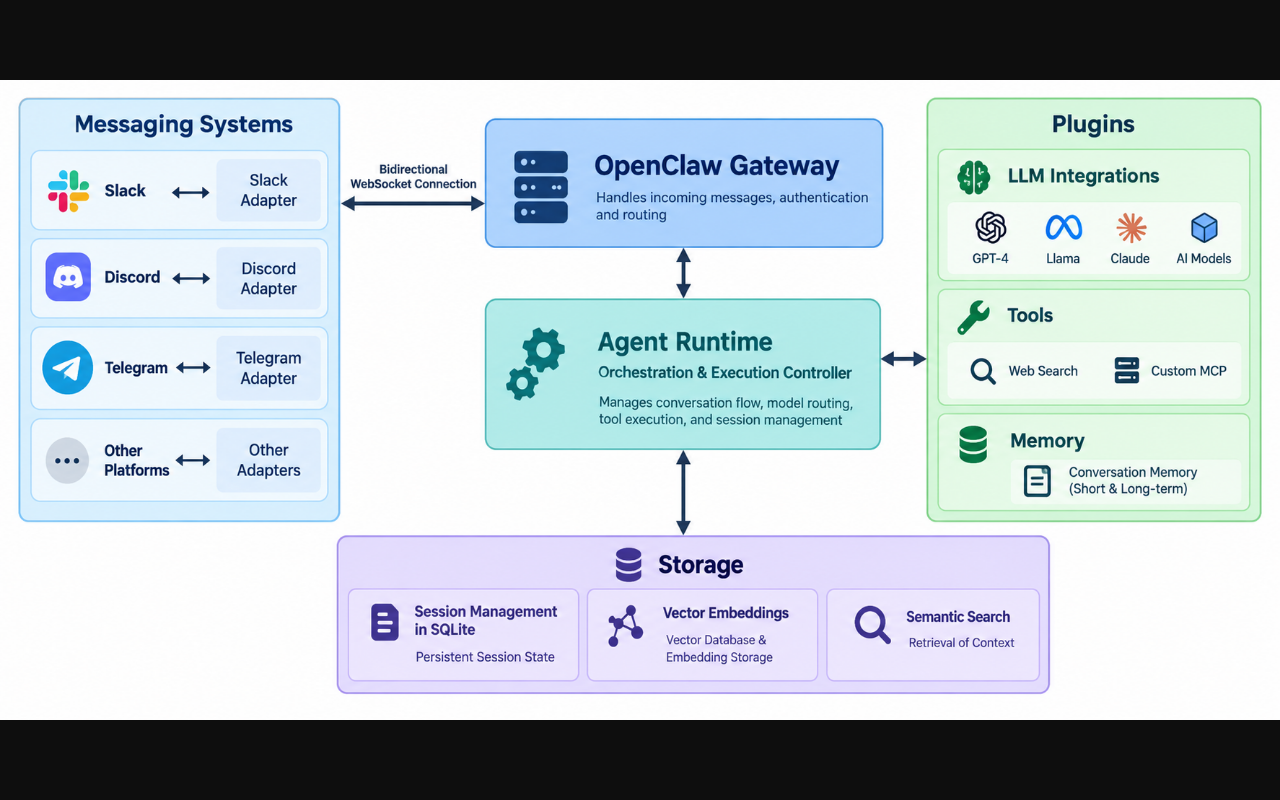
Разбор показывает Gateway, agent runtime и привязки входящих сообщений к agentId. Пример двух агентов полезен, когда личные и рабочие разговоры должны получать разные рабочие каталоги и права.
🔑 Главное
Bindings выбирают агента по наиболее точному совпадению: peer, guild/role, account, channel и default.
Для отдельных агентов показаны собственные workspace и ограничение tools.deny вместе с sandbox.
Конфигурация в статье схематична и не подтверждена запуском. Совет о SSH-подтверждении для публичного сервера противоречит её же оговорке про частные адреса.
⚡ Попробовать за вечер
Создайте в тестовой установке два agentId с разными workspace и привяжите два аккаунта к ним.
Для одного агента запретите write и exec через tools.deny, затем отправьте сообщение на оба аккаунта.
Метрика: доля сообщений, попавших в ожидаемый agentId, и число заблокированных запрещённых вызовов.
из статьи
На картинке: Схема источника показывает Gateway между мессенджерами, runtime агента и хранилищем.
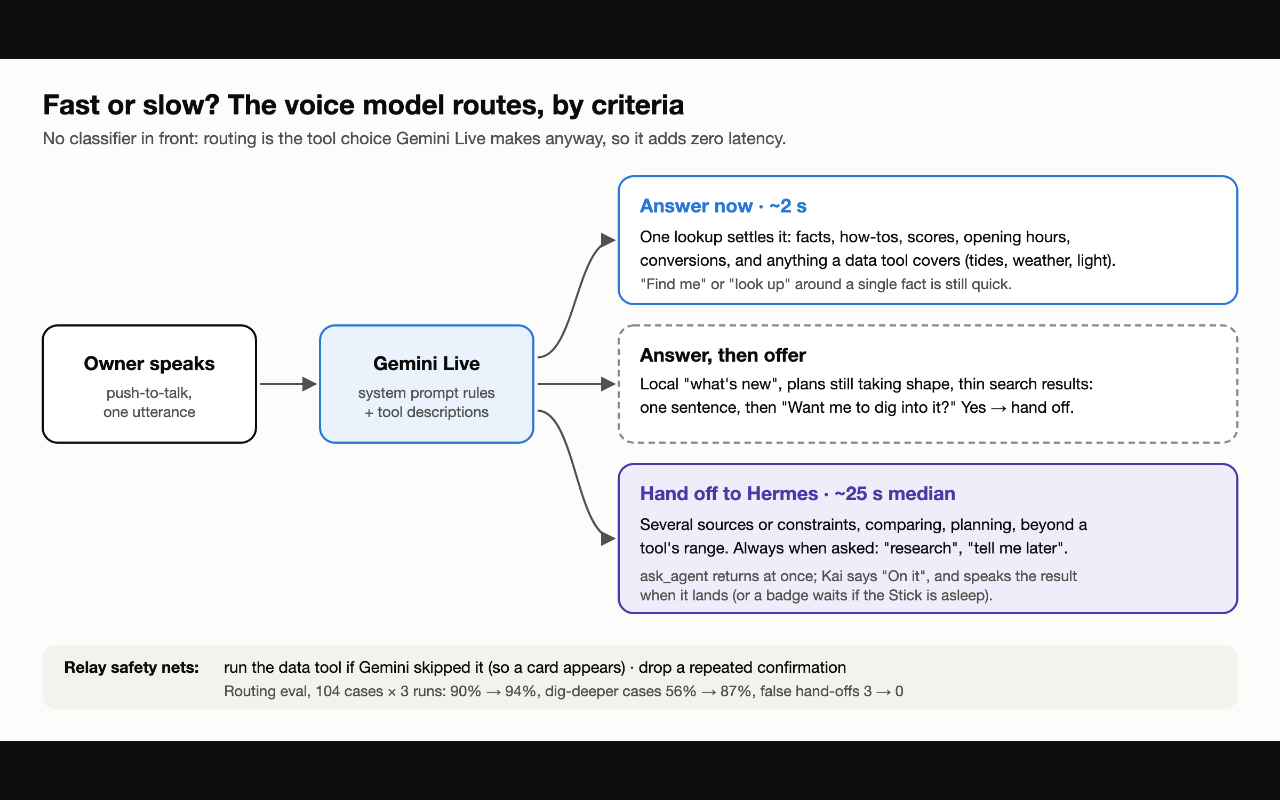
Автор собрал голосового помощника на M5StickS3: устройство передаёт Opus на домашний Python relay, а тот выбирает быстрый Gemini Live или более долгую работу Hermes. Главное здесь — проверяемые критерии передачи задачи.
🔑 Главное
Маршрутизацию автор проверил на 76 репликах из логов и 28 синтетических ловушках, по три прогона каждого случая.
В его текстовом replay общая точность выросла с 90% до 94%; это результат конкретного промпта и набора случаев.
Replay шёл текстом, не настоящим аудио. Выборка одного пользователя и домашний сервер ограничивают переносимость.
⚡ Попробовать за вечер
Разметьте собственные голосовые запросы метками «ответить сразу», «инструмент», «передать агенту» и «уточнить».
Прогоните их трижды с теми же prompt и tools, что работают в устройстве; затем измените критерии передачи.
Метрика: точность выбора маршрута по меткам и число ложных передач на медленный путь.
из статьи
На картинке: Схема автора показывает три пути Gemini Live и защитные проверки relay при передаче Hermes.
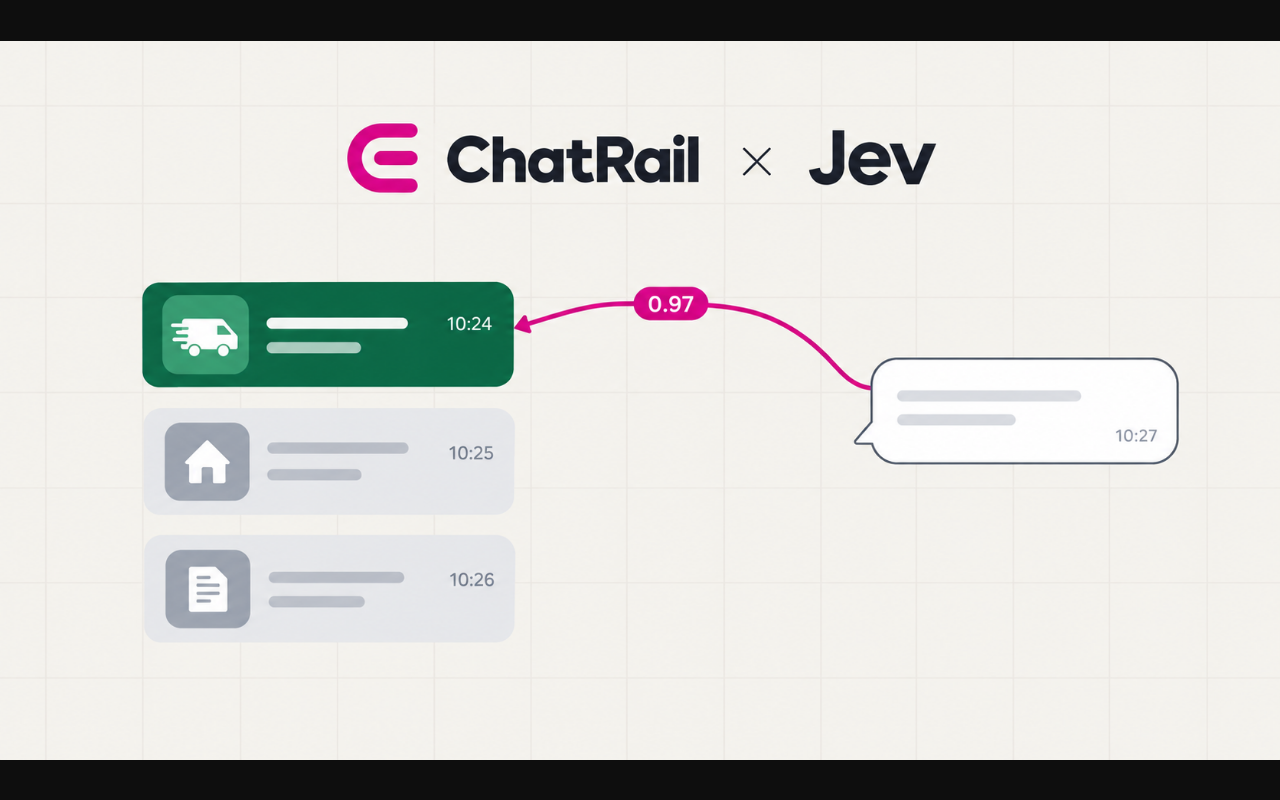
Когда у одного контакта открыто несколько уведомлений, прежнее правило выбирало самое свежее. Автор вставил отдельный шаг выбора одного уведомления или «ни одного», сохранив старое правило как fallback.
🔑 Главное
Jev вызывается только для неоднозначной ветки; выбор с уверенностью ниже 0,8, ошибкой или задержкой свыше двух секунд возвращается к прежнему правилу.
В симуляции API на 12 случаях новое решение выбрало верное уведомление 12 раз против трёх у правила свежести. Случаи пересекаются с первоначальным тестом.
В продакшене ни одно сообщение ещё не попало в эту ветку, порог 0,8 не настроен, а точные промпт и схема не опубликованы.
⚡ Попробовать за вечер
В тестовом роутере оставьте без модели ответы при одном открытом уведомлении; отдельную ветку включите при нескольких.
Записывайте выбранный alert, вероятность, задержку и причину fallback; сравните с правилом свежести на своих неоднозначных сообщениях.
Метрика: доля правильных сопоставлений и доля возвратов к старому правилу на отдельной выборке.
из статьи
На картинке: Превью источника иллюстрирует выбор одного из нескольких открытых уведомлений по короткому ответу.
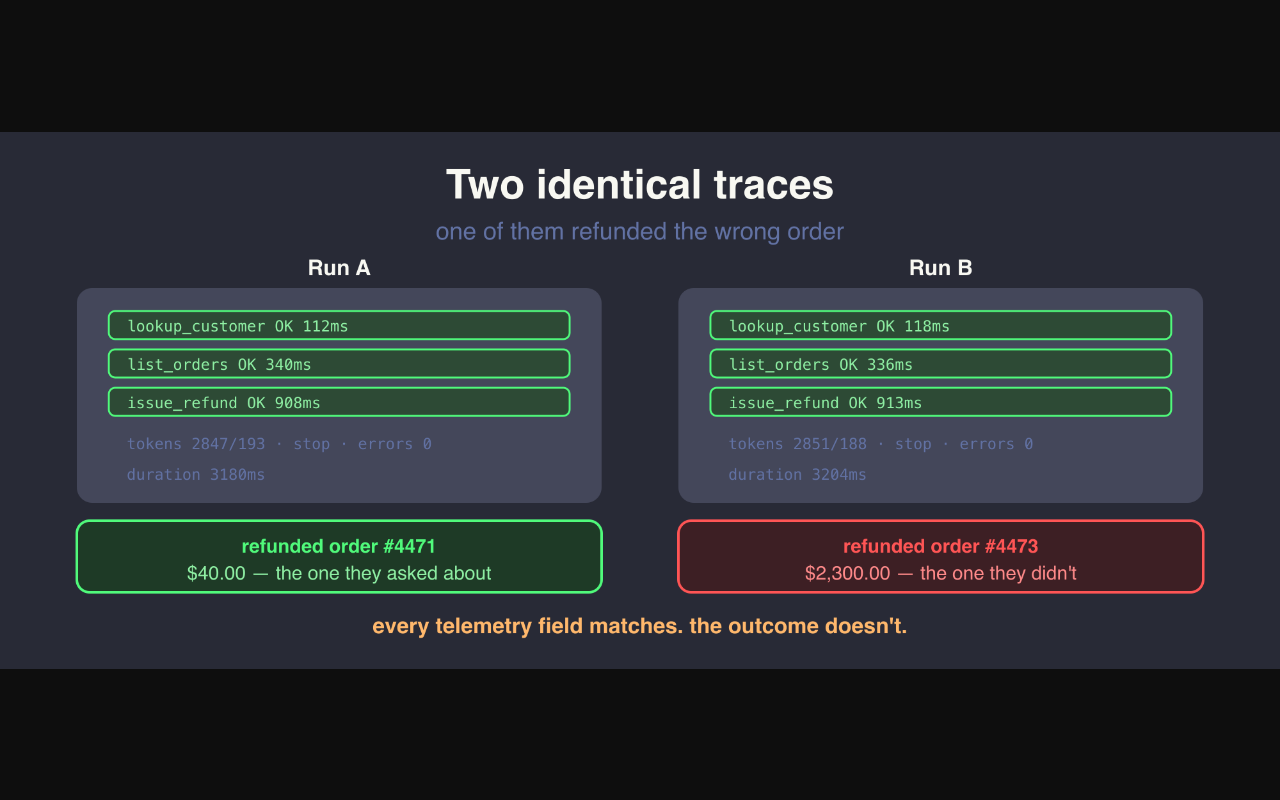
Зелёные вызовы инструментов ещё не означают, что агент выполнил задачу. В примере два запуска сделали возврат денег без ошибок, но один выбрал другой заказ.
🔑 Главное
Автор предлагает взять реальные трассы, особенно длинные цепочки, повторы и случаи передачи человеку.
Для каждой трассы нужно записать проверяемое ожидаемое конечное состояние и сравнить его с изменением базы.
Пример кода иллюстративный: replay, безопасное тестовое состояние и бизнес-условия нужно строить самим.
⚡ Попробовать за вечер
Возьмите 50 разнообразных трасс и для каждой отметьте целевой ID и ожидаемое состояние после действий агента.
Добавьте assert по изменившимся строкам базы и запускайте replay при смене промпта, модели или схемы инструмента.
Метрика: доля запусков, где выполнены все проверяемые постусловия, включая повторы одного сценария.
из статьи
На картинке: Две похожие трассы возврата: вызовы прошли успешно, но деньги ушли по разным заказам.
Статья предлагает перечислить действия, которые агенту нельзя выполнять в конкретном проекте. Текстовые правила полезны, когда их можно продублировать ограничениями инструмента.
🔑 Главное
Формулируйте запреты через точные команды, пути и категории данных, а не через просьбу «быть осторожным».
Храните проектные правила в AGENTS.md и переносите поддерживаемые ограничения в permissions.deny или аналогичную конфигурацию.
Список запретов не бывает полным; статья не даёт готового автоматического тестового harness.
⚡ Попробовать за вечер
Для одной задачи запишите три конкретных запрещённых действия в AGENTS.md.
Добавьте поддерживаемые deny-правила в конфигурацию инструмента и проверьте попытку каждого запрета в тестовой среде.
Метрика: сколько запрещённых вызовов блокирует инструмент до исполнения.
✍ Sai GowthamHackerNoonai-agent-securityprompt-injection-attacks
О чём
Тикет, вложение или найденная страница могут содержать чужую команду. На примере support-агента статья показывает границу между чтением такого текста и отправкой письма.
🔑 Главное
Инструмент send_email должен принимать только исходного отправителя тикета, а не произвольный адрес из текста.
Пример проверяет адрес перед отправкой и пишет scope_violation при отказе.
Код иллюстративный и предполагает, что ticket_context.sender_email уже надёжно установлен; измерения защиты нет.
⚡ Попробовать за вечер
Добавьте проверку получателя непосредственно в send_email, взяв разрешённый адрес из доверенного контекста тикета.
Подайте тикет с просьбой переслать письмо на чужой адрес и убедитесь, что инструмент блокирует вызов и пишет событие.
Метрика: число успешных запрещённых отправок в наборе инъекционных тикетов; целевое значение — ноль.
из статьи
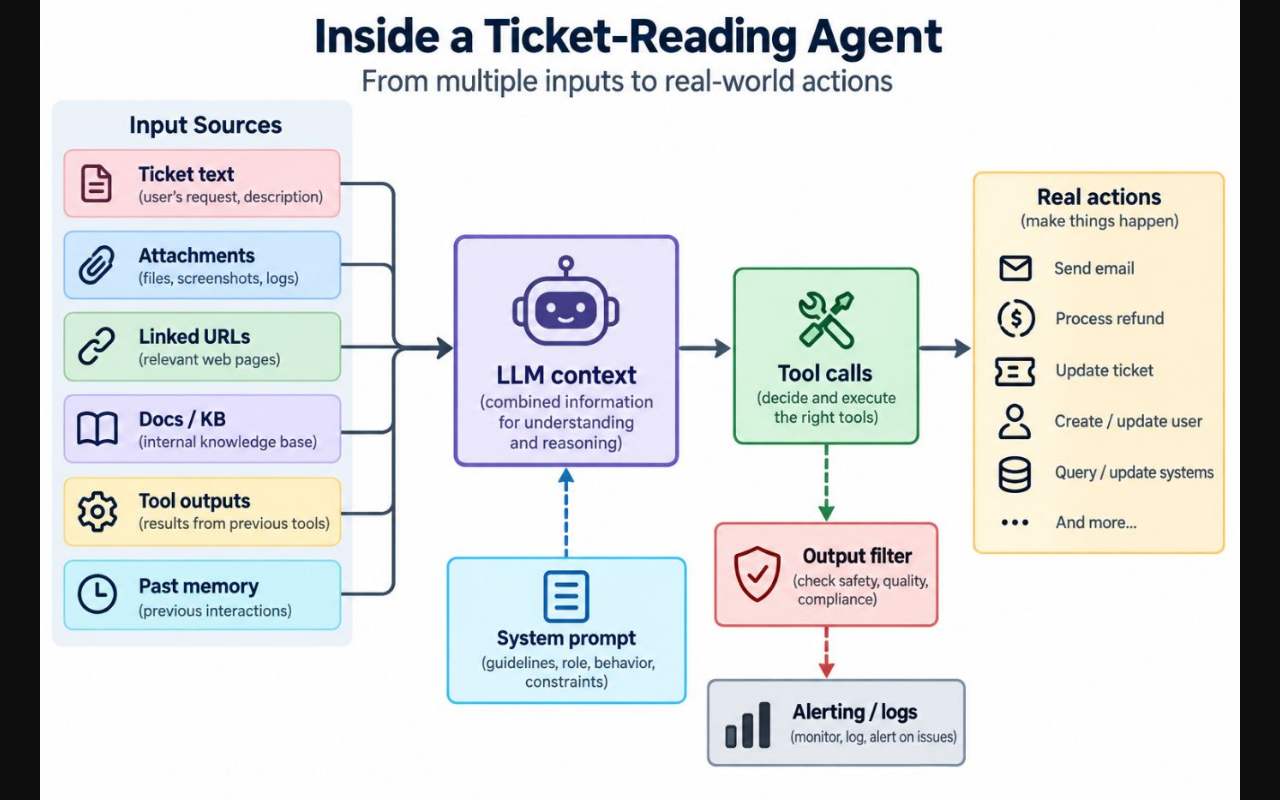
На картинке: Схема источника показывает путь недоверенного текста через контекст агента к инструментам и реальным действиям.
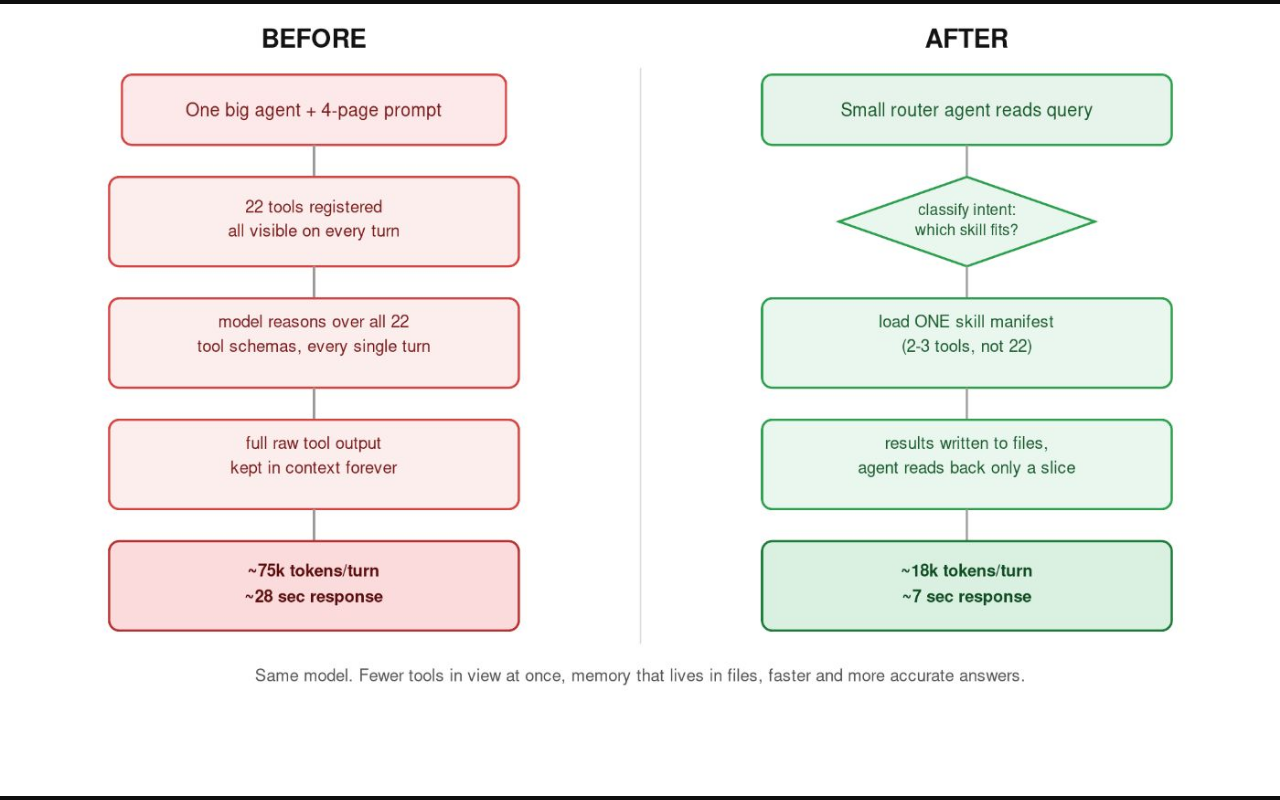
В прод-кейсе один агент видел 22 инструмента и полные ответы на каждом ходе. Команда выделила узкие наборы инструментов по задачам и оставляла в диалоге только нужные фрагменты результатов.
🔑 Главное
Автор сообщает снижение среднего контекста с 75 до 18 тысяч токенов и медианного времени ответа с 28 до 7 секунд на своём наборе прошлых инцидентов.
Схемы инструментов подгружаются по задаче, сырые результаты пишутся в файл, старую историю сжимают.
Размер и состав набора инцидентов не раскрыты; несколько изменений сделаны сразу, поэтому эффект нельзя приписать одному приёму.
⚡ Попробовать за вечер
Зафиксируйте на собственном наборе задач токены, время ответа и ошибки агента с полным списком инструментов.
Выделите небольшой набор инструментов для каждого типа задачи, сохраните сырые результаты в файл и передавайте агенту релевантный срез.
Метрика: токены на ход, медианное время и доля правильных ответов на том же наборе задач.
из статьи
На картинке: Авторская схема сопоставляет агента с 22 постоянно видимыми инструментами и маршрутизацию к узкому набору.
Успешный HTTP-ответ и валидный JSON не показывают, что система выбрала верную сущность и процитировала нужный документ. Автор предлагает небольшой версионированный набор рискованных примеров для запуска перед изменениями.
🔑 Главное
Разделите примеры на baseline, stress, incident и held-out; у каждого сохраните ID, происхождение и ожидаемое поведение.
Проверяйте атрибуцию сущности, дословность цитаты, обоснование вывода и допустимый ответ NONE; смотрите на регрессии по срезам.
Размер 100–150 примеров и ротация части stress-набора — авторские ориентиры без измеренного универсального эффекта.
⚡ Попробовать за вечер
Соберите versioned JSONL с проблемными случаями из продакшена и отдельным held-out срезом.
Добавьте проверки цитаты по исходному документу и идентификатора сущности; запускайте их перед сменой промпта или модели.
Метрика: доля регрессий по каждому рискованному срезу относительно сохранённой версии.
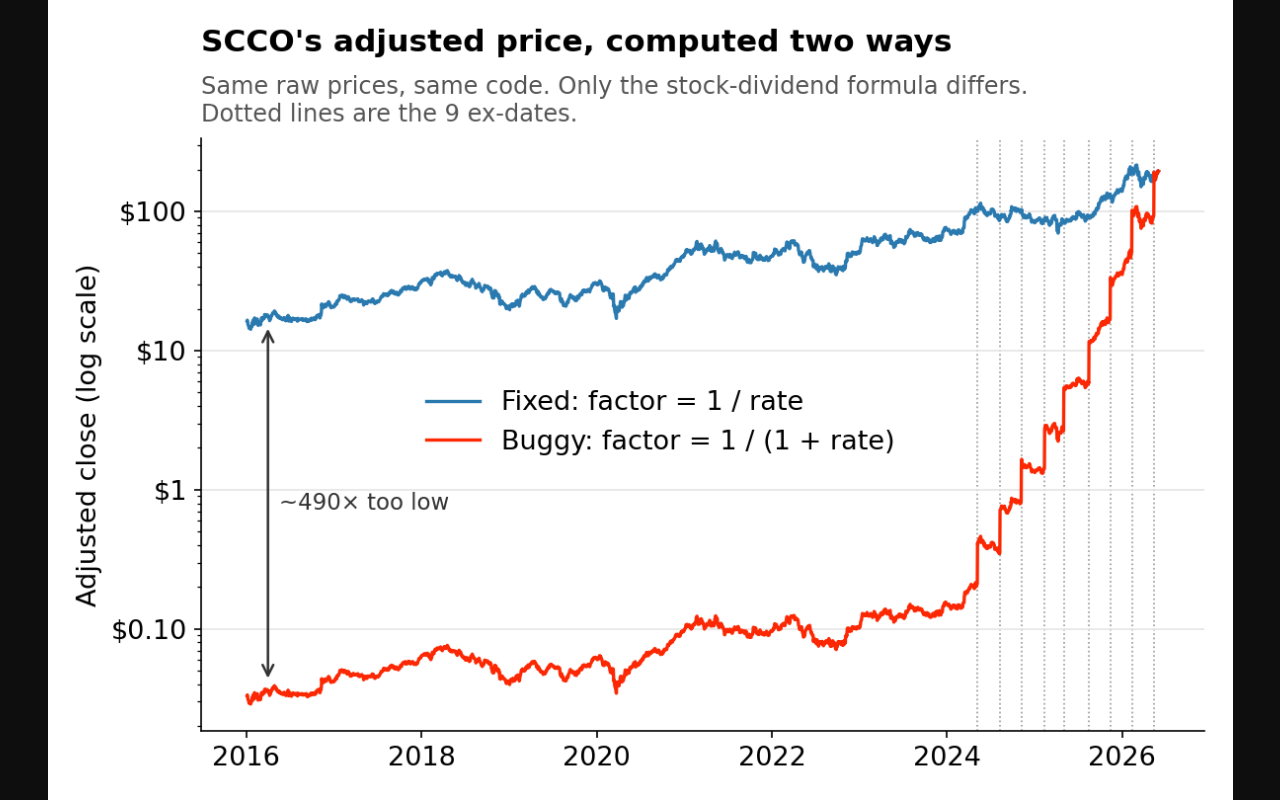
В торговом проекте тест был зелёным, потому что фикстура повторила неверную трактовку входного значения rate. Автор показывает, как сверка с реальными данными обнаружила дефект, пропущенный совместно написанными кодом и тестом.
🔑 Главное
Тест использовал rate: 0.05, хотя такое значение не встречалось в рабочих данных, и потому утверждал ту же ошибку, что и код.
Автор предлагает считать фикстуры проверяемыми гипотезами, а NaN, пустые и отсутствующие входы делать явной ошибкой.
Это один закрытый проект: зелёная сборка пропустила несколько дефектов, так что сам по себе CI-гейт не доказывает безопасность.
⚡ Попробовать за вечер
Выберите один тест AI-сгенерированного кода и сравните значения фикстур с реальным диапазоном входов.
Добавьте падение на NaN, отсутствующих и пустых значениях; вручную проверьте один результат по исходным данным.
Метрика: число ошибочных фикстур и дефектов, которые новый тест поймал до слияния.
из статьи
На картинке: График автора: один и тот же ряд цен с ошибочной и исправленной формулами корректировки.
Автор довёл распознавание до передачи фото в vision-модель, но 43 из 44 успешных проверок были на строках. На реальных обложках он проверил только три случая и один потерял обозначение издания.
Полезный чек-лист: источник, срок жизни, право записи и тест чужого контекста. Конкретная настройка автоматического истечения и трассировки зависимостей в продукте не показана.
Сравнение парсинга сложного PDF предлагает смотреть сырой вывод до ответов модели. Материал заканчивается продвижением LlamaParse, поэтому метод лучше проверить на своём наборе.
 из статьи